文章目录
C++:并发概述(二) C++:并发概述(二) C++:并发概述(二)
Communicating Tasks
我们之前讲到了,要把一个线程函数的结果返回到发起线程的地方,有两种常见方式:1. 让线程函数把结果保存到指针;2. 经由 lambda,把线程函数的结果保存到引用对象中。但是这两种方式不够优雅,而此处的 std::future 和 std::promise 就是更优雅的解法。这是在 task 的概念层面的解法,把底层的锁机制封装起来了,减少代码量。
future 和 promise
当一个 task 想要传递一个值给另一个 task 的时候,它把这个值放入 std::promise,然后另一个 task 可以从 std::future 当中读取这个值
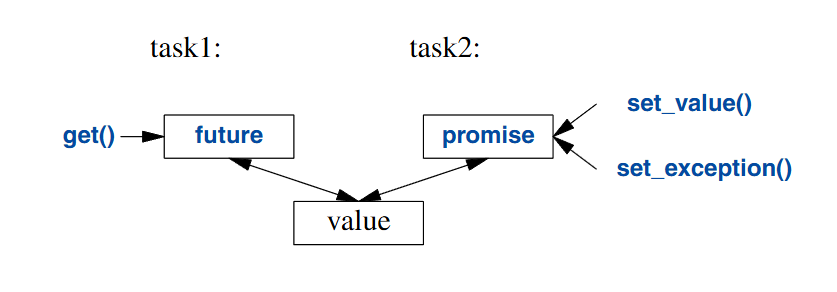
发送方:
这是发送方的线程函数,它接收调用者传入的 std::promise。因此在这个例子中,需要有一个“主线程”来负责创建发送方和接收方的线程。
void f(std::promise<double> pd) {
    try {
        double result;
        pd.set_value(result);
    }
    catch (...) {
        pd.set_exception(current_exception());
    }
}
std::promise<T> 可以通过 set_value() 传递一个 T 类型的值,也可通过 set_exception() 传递异常。这里的 current_exception() 指代当前分支捕获到的异常。
接收方
此处是接收方的线程函数,参数接收一个与发送方的 std::promise 相对应的 std::future。std::future 接收到的异常要么由 g() 处理,要么由 g() 的调用者处理。
- 异常由
g()本身处理的情况:
void g(std::future<double> fd) {
    try {
        double v = fd.get(); // 如果此时 `fd` 当中未有数据,当前线程会阻塞,直到数据到达
        // 使用 v
    }
    catch (...) {
        // 处理错误
    }
}
- 异常由
g()的调用者(在此情况下就是“主线程”)处理的情况:
void g(std::future<double>& fd) {
    double v = fd.get();
}
上面展示的例子是一个主线程 spawn 一个 producer 线程加一个 consumer 线程。然而使用 future 和 promise 最常见的场景就是一个线程在需要某个任务的结果的时候,spawn 一个 worker 线程执行任务,并且通过 future 拿到这个 worker 线程的结果:
而如果是两个平等的线程,则可以互相持有一个 promise 和一个 future,形成双向通信
int main() {
    std::promise<int> p1;
    std::promise<int> p2;

    auto f1 = p1.get_future();
    auto f2 = p2.get_future();

    std::thread t1([&] {
        p1.set_value(10);   // t1 线程向 promise 写入数据,给 t2 线程读取
        int x = f2.get();   // t1 线程从 future 当中读取 t2 线程写入的数据
    });

    std::thread t2([&] {
        p2.set_value(20);
        auto y = f1.get();
    });

    t1.join();
    t2.join();
}
但是 future 和 promise 更适合一次性传递结果。如果两个平等线程要持续来回通信,最好使用消息队列。
交易系统热路径一般不会使用 std::promise 和 std::future,因为它涉及共享状态、等待、调度开销。
packaged_task
std::packaged_task 对 std::promise 和 std::future 的常用操作进行了封装
以下展示了不使用和使用 std::packaged_task 的情况下的例子,都是一个主线程生成一个 worker 线程:
在不适用 std::packaged_task 的情况下:
int add(int a, int b) {
    return a + b;
}

int main() {
    std::promise<double> p;
    auto result = p.get_future();

    std::thread worker {[std::move(p)]() mutable {
        p.set_value(add(10, 20));
    }}

    worker.join();

    std::cout << result.get() << std::endl;
}
在使用 packaged_task 之后,这些操作都被封装了:
int main() {
    std::packaged_task<int(int, int)> task{add};   // add 是我们之前定义的函数

    std::future<int> result = task.get_future();

    std::thread worker{std::move(task), 10, 20};

    worker.join();

    std::cout << result.get() << std::endl;
}
注意在创建 std::thread 的时候,需要 std::move(task),因为 packaged_task 作为资源句柄,不能拷贝,只能移动。它持有 promise 这一资源,并且间接持有这个 task 持有的其它资源。至此,promise + future + packaged_task 让我们无需关心底层的锁。
async()
std::async(f, args...) 把【启动任务】和【获取结果】分开
async() 不保证一定创建新线程。具体实现要看 async() 如何决定。
- 可以选择异步执行,也可延迟到调用
get()时才执行 - 具体使用几个线程,会受到当前 CPU 有几个可用核心影响
async() 返回的类型是 std::future<T>,因此与普通的 future 一样调用 get() 来获取其中的值。
double comp4(vector<double>& v) {
    // 先判断是否有必要使用并发(v 是否足够大)

    auto v0 = &v[0];
    auto sz = v.size();

    // 把这个 vector 分成四段分别计算。最后再汇总
    auto f0 = async(accum, v0, v0 + sz/4, 0.0);
    auto f1 = async(accum, v0 + sz/4, v0 + sz/2, 0.0);
    auto f2 = async(accum, v0 + sz/2, v0 + sz * 3/4, 0.0);
    auto f3 = async(accum, v0 + sz * 3/4, v0 + sz, 0.0);

    return f0.get() + f1.get() + f2.get() + f3.get();
}
async() 适合彼此独立,不共享可变数据的任务。如果把要用到锁的任务放到 async() 当中,那么本质上还是串行, async() 的优势就没了。
请求停止:stop_source / stop_token
如果希望停止线程,直接 kill 不好,因为它持有资源。因此可以使用 stop_source 配合 stop_token 来礼貌请求线程释放资源并停止。
stop_source 和 stop_token 共享一个状态。
- 调用
std::stop_source::get_token()可以获取与一个与当前stop_source绑定的stop_token - 调用
std::stop_source::request_stop()会修改这个共享状态,让所有与当前stop_source绑定的stop_token都感知到这个状态 std::stop_token::stop_requested()可以检查这个状态
以下的例子展现了主线程启动两个工作线程来做某件事(比如寻找某个目标),一旦其中一个线程达到了目的,就让两个线程都停止:
atomic<bool> finished = false;

int main() {
    std::stop_source ss{};
    // 启动两个工作线程
    std::jthread t1(work, ss.get_token()); // 把 stop_token 传入线程函数
    std::jthread t2(work, ss.get_token());

    while (!finished) {
        this_thread::sleep_for(10ms);
    }
    ss.request_stop();  // 把共享状态置为停止
}
在工作线程函数当中,一般会写一个工作循环,在检查条件当中写上 !tok.stop_requested()。
这样如果外界请求这个线程停止,这个工作线程在下一次循环就会发现,进而结束循环、函数返回、线程结束。
void work(std::stop_token tok) {
    while (!tok.stop_requested()) {
        // work
        if (work_done) {
            finished.store(true);
            return;
        }
    } // 如果请求停止了,则退出循环并停止线程
}
使用标准库的 stop_token 相比手搓一个布尔类型的 stop_token,好处体现在:
- 线程安全(如果手动实现,至少要用
std::atomic<bool>) - 支持一个
stop_source生成多个stop_token,多个任务一起响应同一个停止请求 - 支持
stop_callback,收到请求时自动执行回调
// TODO:可以把 simex 和 jev-quant 当中线程的 run_ 标识换成 stop_token
Coroutines
Coroutine 就是协程。只要一个函数使用了以下关键词,它就是 Coroutine:
-
co_yield -
co_return -
co_await -
co_yield会返回一个值,然后下次调用这个函数的时候,从这个co_yield()的下一行继续运行。因此co_yield给函数带来了 “可以暂停” 的特性,因此在每次调用之间,函数的内部状态得以保存 -
co_return会结束协程; -
co_await something会等这个东西准备好,如果没准备好就暂停协程。使用co_await的 coroutine 就是异步的,否则是同步的。
下面这个例子是同步的,体现了 co_yield 的特性:
std::generator<long long> f() {  // std::generator 是 C++ 23 引入的
    co_yield 1;
    co_yield 2;
    co_yield 3;
}

int main() {
    std::cout << f() << std::endl; // 输出 1
    std::cout << f() << std::endl; // 输出 2
    std::cout << f() << std::endl; // 输出 3
}
而如果给 coroutine 加上一个 while(true) 循环,它可以永不结束运行,持续地保存内部状态,每次调用时吐出一个值
因此可以用 Coroutine 来生成斐波那契额数列:
std::generator<long long> fib() {
    long long a = 0, b = 1;

    while (true) {
        auto next = a + b;
        co_yield next;
        a = b;
        b = next;
    }
}

void user(int max) {
    while (max--) {
        cout << fib() << ' ';
    }
}
max 规定了循环的次数,而每次循环调用 fib() 的时候,fib() 都在 co_yield() 处返回一个值。并且下一轮循环调用 fib() 的时候,从上一轮调用的 co_yield() 的下一行继续运行。
std::generator 是 C++ 23 引入的,用于配合 coroutine 的 co_yield 使用,允许使用 co_yield 逐个生成值,而不是一次性把所有值装入容器
既然 Coroutine 和函数对象都可以保存状态,有必要进行区分:
- 用 Coroutine 更好的情况:需要 “暂停->恢复->再暂停” 的状态机、generator、异步流程:
- 函数对象更好的情况:普通回调函数
// TODO:之后可以研究一下 coroutine 与交易系统当中的事件驱动架构有什么联系 // TODO:还可以研究一下订单状态机能否用 coroutine 来写,以及生产级交易系统当中是否建议这么做
Cooperative Multitasking
用很多 coroutine 表示很多小任务,由一个 scheduler 决定下一步恢复哪个 coroutine
可以把系统当成 networks of simple tasks (coroutines) that collaborate to complete complex tasks
每一个 task 负责整个任务当中的一小块
可以让 coroutine 之间通过消息队列来通信。//??:等下,WTF。前面讲到的 coroutine 只是一种特殊的函数。这里的意思是可以把 coroutine 当成执行任务的函数,然后作为 std::thread 的任务函数来使用吗?
//??:coroutine 如果要和 BLLA 当中的交易系统结合起来,如何结合?BLLA 当中的线程是用类来表示的(类里面有 run() 方法),肯定不是简单地把 run() 改成 coroutine。。。
可以把每个 task 接入事件队列。//??:coroutine 到底是如何与事件驱动架构结合的?就是前面说的 “用很多 coroutine 表示很多小任务,由一个 scheduler 决定下一步恢复哪个 coroutine” 吗?
//??:这里涉及的 “A form of polymorphism that allows us to keep lists of events containing different kinds of coroutines and invoke them independently of their types.” 是啥意思?
coroutine 使用的空间很小(相较于线程),如果 task 很多的话两者空间效率差距较大。因此 coroutine 之间的 context switch 也比线程/进程之间的 context switch 快很多。//??:所以 coroutine 的并发不是线程级别并发??
C++ 26 对于