文章目录
交易系统:OrderServer 与 Market Data Publisher 交易系统:OrderServer 与 Market Data Publisher 交易系统:OrderServer 与 Market Data Publisher
本章覆盖 Order Server 和 Market Data Publisher 两个与客户端相互通信的组件
撰写编码协议
这部分先讲本书的交易系统当中,MarketDataPublisher 组件与客户端通信使用的编码协议,然后讲 OrderServer 组件与客户端通信使用的编码协议,最后讲在生产中使用的 Single Binary Encoding 协议。
Market Data Protocol
撮合引擎内部使用的用来传递市场更新的结构体是 MEMarketUpdate,这是内部格式;而此处我们需要定义 MarketDataPublisher 是面向广大市场参与者的公共格式。其实就是在 MEMarketUpdate 的基础上增加了序列号 seq_num_,客户端之后会用这个序列号来检测 UDP 丢包、进行恢复。
#pragma pack(push, 1)
struct MDPMarketUpdate {
private:
    size_t seq_num_;
    MEMarketUpdate me_market_update_;
};
#pragma pack(pop)
为了满足 snapshot stream 的需要,我们在 MarketUpdateType 枚举值(对应 me_market_update_.type_ 这个对象的可能取值)当中新增了以下几种消息类型:
CLEAR:清空客户端本地订单簿SNAPSHOT_START:快照开始SNAPSHOT_END:快照结束
另外,新增以下一条 LFQueue,用于在 MarketDataConsumer 与 SnapshotSynthesizer 之间通信:
typedef Common::LFQueue<Exchange::MDPMarketUpdate> MDPMarketUpdateLFQueue;
Order Protocol
#pragma pack(push, 1)
struct OMClientRequest {
    size_t seq_num_;
    MEClientRequest me_client_request_;
};

struct OMClientResponse {
    size_t seq_num_;
    MEClientResponse me_client_response_;
};
#pragma pack(pop)
这里的 OM 指的是 Order Management
本书当中使用 #pragma pack(1) 定义的的 C++ 结构体可以做到类似 Single Binary Encoding 的编码,因为字段按照固定顺序排列,最终
这里没有一个独立的序列化器把结构体字段转成二进制,而是依赖编译器根据结构体定义和 #pragma pack 来决定内存布局。这个对象在内存中的连续字节就是随后被发送的二进制。在 TCPSocket::send() 当中,memcpy 把内存中的字节复制到 send_buffer_,随后 OrderServer 线程通过 epoll 等待 socket 可写,然后 socket 把内存缓冲区中的字节发送到对端。实际上,由于服务器与客户端都是 C++,对端收到消息后把二进制 reinterpret_cast 成 struct 就可以了。
所以本书的实现可以看成是一个建议的 Binary Protocol 实现。下面我们看一下真正的 SBE 的实现。
Simple Binary Encoding (SBE)
SBE 协议是开源的,其 Github 仓库链接。它可以用来编码任何结构化信息,甚至包括图片、视频、PDF 等,但是 SBE 的典型用途是低延迟结构化信息,例如订单、行情、执行回报。所以如果在本书的交易系统当中使用 SBE,那么 Market Data Publisher, Order Server/Gateway 都可以用 SBE 来编码。
交易所与客户端之间使用 SBE 来通信的流程大致是:
- SBE 社区提供一套标准,定义 SBE XML schema 的语法以及允许的结构
- 交易所根据这套标准,编写一套包含业务语义的 SBE XML schema,当中可能包含
OrderId,price等字段 - SBE 社区提供 SBE tools,能够根据规范的 SBE XML Schema 生成一系列 codec (是 coder-decoder 的简写,编码译码器)
- 交易所和客户端使用 SBE tools 根据交易所定义好的 schema 生成 codec。这一系列的 codec 可能包含 OrderEncoder, OrderDecoder, MarketDataEncoder, MarketDataDecoder
- 应用层使用这套 Encoder, Decoder 来进行通信时,只需要知道它们提供哪些 API,无需了解底层机制。具体有哪些 API,完全由 schema 决定,它们反映业务语义,比如:
OrderEncoder encoder;
encoder.wrapForEncode(buffer, 0, sizeof(buffer))
       .side(Side::BUY)
       .qty(100)
       .price(12345);

OrderDecoder decoder;
decoder.wrapForDecode(buffer, messageOffset, actingBlockLength, actingVersion, bufferLength);
auto side = decoder.side();
auto qty = decoder.qty();
auto price = decoder.price();
OrderEncoder 只负责把编码好的二进制消息放入内存缓冲区,后续由 OrderGateway 线程的 epoll 唤醒 socket 发送消息,这些就不是 encoder 的职责了。
我们可以根据 XML schema 和 SBE message header 推断最终 encoder 放到内存缓冲区当中的二进制信息的大概样貌
15 00 01 00 07 00 00 00  // 这是 header,包含 blockLength、templateId、schemaId、version
2A 00 00 00 00 00 00 00  // 这是 orderId = 42
01                       // 这是 side = BUY = 1
64 00 00 00              // 这是 qty = 100
39 30 00 00 00 00 00 00  // 这是 price = 12345
据我目前所知,中国的交易所并不使用 SBE,但是 SBE 是理解交易系统编码协议的很好的切入口。
OrderServer
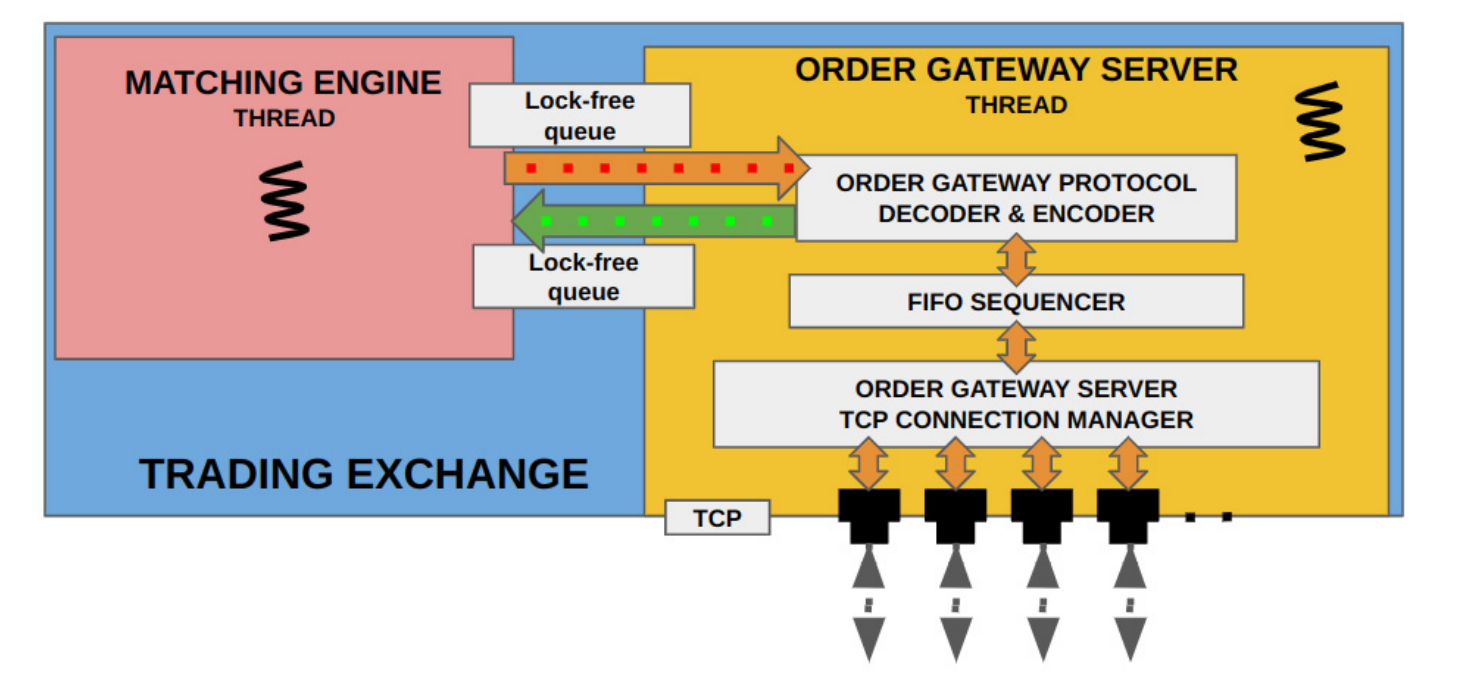
OrderServer 的职责是:
- 创建 TCP 服务端并接收客户连接(监听 socket 的职责)
- 从 TCP 缓冲区按固定大小解析
OMClientRequest(这个 TCP缓冲区指的是 Server 端的缓冲区?) - 检查客户端 client_id, socket 映射和请求序号(什么是 socket 映射和请求序号?)
- 把请求交给 OrderServer 内部的
FIFOSequencer排序 - 把排序后的内部
MEClientRequest放入 Matching Engine 的无锁队列
如果是返回私有订单回调,流程则是:
- 从 Matching Engine 接收
MEClientResponse - 根据
client_id找到对应 TCP 连接,封装成OMClientResponse并返回客户端
OrderServer 的成员对象
class OrderServer {
private:
    const std::string iface_; // OrderServer 监听所使用的本机网络接口
    const int port_ = 0;      // OrderServer 对外监听的本地接口。

    ClientResponseLFQueue *outgoing_responses = nullptr; // OrderServer 与 MatchingEngine 通信的队列。这里只是指针,不拥有

    volatile bool run_ = false;

    std::string time_str_;
    Logger logger_;

    std::array<size_t, ME_MAX_NUM_CLIENTS> cid_next_outgoing_seq_num_;
    std::array<size_t, ME_MAX_NUM_CLIENTS> cid_next_exp_seq_num_;

    std::array<Common::TCPSocket*, ME_MAX_NUM_CLIENTS> cid_tcp_socket_;
    Common::TCPServer tcp_server_;

    FIFOSequencer fifo_sequencer_;
};
iface_ 是网络接口名称。OrderServer 需要通过操作系统 API 找到接口名称对应的本机 IP 地址,然后将 socket 绑定到该接口。port_ 本身表示 OrderServer 机器上的一个端口。 OrderServer 的监听 socket 和很多连接 socket 绑定的本机 IP 地址和本机端口都是一致的;不同连接 socket 的对端 IP 地址和端口号各异。
cid_next_outgoing_seq_num_ 和 cid_next_exp_seq_num_ 分别用来保存期望下一个 ClientResponse 和 ClientRequest 应当携带的 seq_num_ 序列号。
cid_tcp_socket_ 保存指向每一个与客户端通信使用的连接 socket 的指针。此处的三个 std::array 都以 client_id 作为下标。client_id 实质上是 0 到 ME_MAX_NUM_CLIENTS - 1 范围内的一个整数。
tcp_server_ 是 OrderSever 内部的子组件,负责管理一切 socket 事务
注意此处 OrderServer 并没有一个专门的子组件来负责 ClientRequest 或是 ClientResponse 的编码与解码,因为本书实现的编码协议很简单且服务器与客户端都是 C++,所以发送方直接发送内存中对象的二进制字段,接收方直接接收后使用 reinterpret_cast 即可。若是使用真实的 SBE 协议,则通常有独立的 OrderEncoder / OrderDecoder。
OrderServer::OrderServer()
OrderServer::OrderServer(ClientReqestLFQueue* client_requests, ClientResponseLFQueue* client_responses_, const std::string &iface, int port)
    : iface_(iface), port_(port), outgoing_responses_(client_responses), logger_("exchange_order_server.log"), tcp_server_(logger_), fifo_sequencer_(client_requests, &logger_)
{
    cid_next_outgoing_seq_num_.fill(1); // 把 std::array 当中的所有元素都填上 1
    cid_next_exp_seq_num_.fill(1);
    cid_tcp_socket_.fill(nullptr);

    tcp_server_.recv_callback_ = [this](auto socket, auto rx_time) { recvCallcack(socket, rx_time); };
    tcp_server_.recv_finished_callback_ = [this]() { recvFinishedCallback(); };
}
tcp_server_ 本身是通用网络组件,不知道收到数据后如何处理,这里把 recvCallback() 作为函数对象(lambda)赋值给 tcp_server_.recv_finished_callback_。
OrderServer::start()
与 MatchingEngine::start() 一样,保持不阻塞,把工作循环放在 run() 当中
auto OrderServer::start() {
    run_ = true;
    tcp_server_.listen(iface_, port_);
    Common::creatAndStartThread(-1, "Exchange/OrderServer", [this]() { run(); });
}
OrderServer::stop()
就这么简单
auto OrderServer::stop() {
    run_ = false;
}
OrderServer::run()
auto OrderServer::run() noexcept {
    logger_.log("%:% %() %\n", __FILE__, __LINE__, __FUNCTION__, Common::getCurrentTimeStr(&time_str_));

    while (run_) {
        tcp_server_.poll();

        tcp_server_.sendAndRecv();

        // 遍历无锁队列当中每一条私有回调消息
        for (auto client_response = outgoing_responses_->getNextToRead(); outgoing_responses_->size() && client_response; client_response = outgoing_responses_->getNextToRead()) {

            // 获得 client_id
            client_id = client_responses->client_id_;

            // 获得这条回调消息应有的序列号,这里用了引用
            auto& next_outgoing_seq_num = cid_next_outgoing_seq_num_[client_id];

            logger_.log("%:% %() % Processing cid:% seq:% %\n", __FILE__, __LINE__, __FUNCTION__, Common::getCurrentTimeStr(&time_str_), client_id, next_outgoing_seq_num, client_response->toString());

            // 确保该客户端对应的连接 socket 存在
            ASSERT(cid_tcp_socket_[client_id] != nullptr, "Dont have a TCPSocket for ClientId:" + std::to_string(client_id));

            cid_tcp_socket_[client_id]->send(&next_outgoing_seq_num, sizeof(next_outgoing_seq_num));
            cid_tcp_socket_[client_id]->send(client_response, sizeof(client_response));

            outgoing_responses_->updateReadIndex();

            ++next_outgoing_seq_num;
        }
    }
}
OrderServer::recvCallback()
最终注册到 OrderServer::tcp_server_ 所持有的连接 socket 的 TCPSocket::recv_callback_ 的回调函数。负责从这个连接 socket 的应用层缓冲区(即 inbound_data_)的字节流中按照 OMClientRequest 的字节数提取出完整的请求消息,经过 reinterprec_cast 还原成 OMClientRequest 结构体,经过简单校验后加入 fifo_sequencer_。
auto OrderServer::recvCallback(TCPSocket *socket, Nanos rx_time) noexcept {
    logger_.log("%:% %() % Received socket:% len:% rx:%\n", __FILE__, __LINE__, __FUNCTION__, Common::getCurrentTimeStr(&time_str_), socket->socket_fd_, socket->next_rcv_valid_index_, rx_time);

    if (socket->next_rcv_valid_index_ >= sizeof(OMClientRequest){
        // 这里前者是 rcv_buffer 中当前已有的有效字节数;后者是一条完整请求的字节数
        // 这里是想要判断接收缓冲区中是否至少有一条完整消息
        // 如果不足,则等到下一次再读取解析

        size_t i = 0; // i 表示当前要解析的消息在缓冲区中的起始位置
        for (;
            i + sizeof(OMClientRequest) <= socket->next_rcv_valid_index_;
            i += sizeof(OMClientRequest)) {
                // 每次解析一条消息,因此 i 的步进是 sizeof(OMClientRequest)

                auto request = reinterpre_cast<const OMClientRequest*>(socket->inbound_data_.data() + i);

                logger_.log("%:% %() % Received %\n", __FILE__, __LINE__, __FUNCTION__, Common::getCurrentTimeStr(&time_str_), request->toString());

                if (UNLIKELY(cid_tcp_socket_[request->me_client_request_.client_id_] == nullptr)) { // 这是当前客户的第一条消息,当前 socket* array 还未有这个客户端的 socket
                    cid_tcp_socket_[request->me_client_request_.client_id_] = socket;

                    if (cid_tcp_socket_[request->me_client_request_.client_id_] != socket) {   // 当前这个客户端的 socket 与当前 socket 不符,应该拒绝该请求

                        logger_.log("%:% %() % Received ClientRequest from ClientId:% on different socket:% expected:%\n", __FILE__, __LINE__, __FUNCTION__, Common::getCurrentTimeStr(&time_str_), request->me_client_request_.client_id_, socket->socket_fd_, cid_tcp_socket_[request->me_client_request_.client_id_]->socket_fd_);

                        continue;
                    }

                    // 这个客户下一个应该的 seq_num
                    auto &next_exp_seq_num = cid_next_exp_seq_num_[request->me_client_request_.client_id_];

                    if (request->seq_num_ != next_exp_seq_num) { // seq_num 不符

                        logger_.log("%:% %() % Incorrect sequence number. ClientId:% SeqNum expected:% received:%\n", __FILE__, __LINE__, __FUNCTION__, Common::getCurrentTimeStr(&time_str_), request->me_client_request_.client_id_, next_exp_seq_num, request->seq_num_);

                        continue;
                    }

                    ++next_exp_seq_num;

                    fifo_sequencer_.addClientRequest(rx_time, request->me_client_request);
                }

                // 此时已经解析完本轮 TCP 字节流当中完整的 ClientRequest 消息,i 已经指向了最后“半条”消息的起始点。
                // 换个角度理解,i 表示在本轮字节流范围内,目前已读的消息相比于字节流开头的 offset

                memcpy(socket->inbound_data.data(), socket->inbound_data_.data() + i, socket->next_rcv_valid_index_ - i)
                // 这里的 memcpy 就是要把那“半条消息”搬到缓冲区开头

                socket->next_rcv_valid_index_ -= i;
                // 然后把有效 index 减去本轮已读的 offset,使其反映缓冲区当中有效信息截止点

            }
    })

}
函数内的 for (; i + sizeof(OMClientRequest) <= socket->next_rcv_valid_index_; i += sizeof(OMClientRequest)) 这个循环遍历当前 socket 接收缓冲区中所有完整的 OMClientRequest。
是有可能一次读到多条消息的,因为 TCP 字节流传输就是有可能一次 recvmsg() 读到半条消息,或者一条半消息。意味着有可能一次读到的多条消息共享一个 rx_time,因此无法知道每条消息到达内核的精确事件,因此只能做近似公平排序,而不是逐消息硬件时间排序。如果要改进的话,要在网卡和驱动上启动硬件时间戳之类的。
socket->inbound_data.data() 这个缓冲区是不会把其中的信息都清除的,只有每次对其中的信息进行覆写。控制读写位置的核心变量是 next_rcv_valid_index_。缓冲区只在构造时 resize(TCPBufferSize) 一次,之后从不 clear。它就是一块固定的内存,旧的字节会一直留着,只是变成无用的垃圾数据。有效区域是 [0, next_rcv_valid_index_],这之外的内容没有意义。
由于 recvCallback() 第一次读取这个缓冲区是从 0 开始,且每次读取的字节数都是一个 OMClientRequest 的字节数的整数倍,因此可以确保读入的每个 OMClientRequest 都是完整的 OMClientRequest。
socket 收到数据之后,回调会逐层通知到 OrderServer,路径是:
- TCPServer::sendAndRecv()
- TCPSocket::sendAndRecv()
- TCPSocket::recv_callback_(this, kernel_time)
- OrderServer::recvCallback()
recvCallback() 与 recvFinishedCallback() 的分工:
recvCallback(socket, rx_time):每当一个客户端 socket 读到数据时调用。它解析并校验该客户端的请求,再连同接收事件交给FIFOSequencer暂存recvFinishedCallback():这一轮所有可读 socket 都处理完后只调用一次。让 FIFOSequencer 将本轮收集的请求按事件排序,再发布给 Matching Engine
OrderServer::recvFinishedCallback()
负责把若干个 socket 的订单请求送入 FIFOSequencer。作为回调函数,由 TCPServer::sendAndRecv() 在本轮 epoll 的所有 receive_sockets_ 的读取事件处理完毕后调用。也即是说,在调用当前方法的时候,已经完成以下的事项:receive_sockets_ 当中的每一个 socket 已经把内核缓冲区的数据放到应用层缓冲区,并且调用注册好的回调函数 OrderServer::recvCallback() 将 OMClientRequest 消息放入 fifo_sequencer_.pending_client_requests_ 当中。因此在方法只是调用 fifo_sequencer_.sequenceAndPublish() 把 fifo_sequencer_.pending_client_requests_ 当中的请求按时间顺序排序。
auto OrderServer::recvFinishedCallback() noexcept {
    fifo_sequencer_.sequenceAndPublish();
}
FIFOSequencer
核心目的是保证公平
OrderServer收到请求时记录软件接收时间- 请求先进入待等待数组(为什么需要有等待数组?)
sequenceAndPublish()按接收时间排序- 按 FIFO 顺序写入 Matching Engine 的无锁队列
FIFOSequencer::addClientRequest() 由 recvCallback() 针对 OrderServer 收到的每条 OMClientRequest 逐条调用,只负责将 (rx_time, request) 追加到内部暂存数组中,不排序、不发布。
FIFOSequencer::sequenceAndPublish() 由 recvFinishedCallback() 针对整批 socket 调一次,负责使用 std::sort 按 recv_time_ 排序,然后逐条写入无锁队列,然后把 pending_size_ = 0,等待下一批。
FIFOSequencer 的成员对象
class FIFOSequencer {
private:
    clientRequestLFQueue* incoming_requests_ = nullptr; // FIFOSequencer 也要有与撮合引擎通信的无锁队列

    std::string time_str_;
    Logger* logger_ = nullptr;

    struct RecvTimeClientRequest { // 就是把 request 的结构体和到达时间再加一层封装
        Nanos recv_time_ = 0;
        MEClientRequest request_;

        auto operator<(const RecvTimeClientRequest& rhs) const {  // 这是小于的比较符号
            return (recv_time_ < rhs.recv_time_);
        }
    };

    // 每处理一个 OMClientRequest 那么大的 TCP 字节流,就写入这个 array 一次
    // 然后等到触发 sequenceAndPublish() 的时候再写入与撮合引擎的无锁队列
    std::array<RecvTimeClientRequest, ME_MAX_PENDING_REQUESTS> pending_client_requests_;
    size_t pending_size_ = 0; // 表示上述 array 的大小
};
FIFOSequencer::addClientRequests()
把给出的 MEClientRequest 对象加入 FIFOSequencer::pending_client_requests_
Q:为什么在这一步不保证加入是按照时间顺序的,还需要额外的 sequenceAndPublish() ?
A:因为 FIFOSequencer::addClientRequests() 被调用的顺序由 TCPSocket::sendAndRecv() 决定,TCPSocket 在这个函数内调用回调函数,进而调用 FIFOSequencer::addClientRequests()。而 TCPSocket::sendAndRecv() 被调用的顺序由 TCPServer 遍历 receive_sockets_ 的顺序决定,这个顺序并不一定等于消息到达内核的顺序。为了公平,需要在 FIFOSequencer::sequenceAndPublish() 当中再按照消息到达内核的时间重新排序。
auto FIFOSequencer::addClientRequests(Nanos rx_time, const MEClientRequest& request) {
    if (pending_size >= ME_MAX_PENDING_REQUESTS) {
        FATAL("Too many pending requests");
    }

    pending_client_requests_.at(pending_size++) = RecvTimeClientRequest{rx_time, request};
}
把元素加入 pending_client_requests_ 本身不会让元素有序是吗?为什么?这里不是都已经按照加入的时间来加入了吗?
FIFOSequencer::sequenceAndPublish()
把 pending_client_requests_ 当中的 RecvTimeClientRequest 按照时序排列,然后加入到 OrderServer 与撮合引擎通信的无锁队列 incoming_requests_ 当中
auto FIFOSequencer::sequenceAndPublish() {
    // 当前 pending_client_requests_ 为空,直接返回
    if (UNLIKELY(!pending_size_)) { return; }

    logger_->log("%:% %() % Processing % requests.\n", __FILE__, __LINE__, __FUNCTION__, Common::getCurrentTimeStr(&time_str_), pending_size_);

    // 对 pending_client_requests_ 当中的元素排序
    // 我们自定义了 FIFOSequencer::RecvTimeClientRequest::operator<,会按照 recv_time 排序
    std::ranges::sort(pending_client_requests_.begin(), pending_client_requests_.begin() + pending_size_);

    // 把客户请求加入与撮合引擎的无锁队列
    for (size_t i = 0; i < pending_size_; ++i) {
        // const 引用避免复制元素
        const auto &client_request = pending_client_requests_.at(i);

        logger_->log("%:% %() % Writing RX:% Req:% to FIFO.\n", __FILE__, __LINE__, __FUNCTION__, Common::getCurrentTimeStr(&time_str_), client_request.recv_time_, client_request.request_.toString());

        auto next_to_write_to = incoming_requests_->getNextToWriteTo();

        next_to_write_to* = client_request.request_;

        incoming_requests_->updateWriteIndex();
    }

    // 把 pending_client_requests_ 的元素计数重新置零
    pending_size_ = 0;
}
MarketDataPublisher
SnapshotSynthesizer 负责间隔一段时间就向 snapshot stream 发送一次订单簿快照
这个订单簿快照其实不是一个真正的 “快照”,而是短时间内发送 CLEAR 和多个 ADD 事件,其中 CLEAR 告诉客户端,随后的 ADD 事件将从零开始重建订单簿。而订单簿上的每一个订单都对应后续的一个 ADD 事件。
SNAPSHOT_START 标记快照流开始;SNAPSHOT_END 标记快照流结束
SnapshotSynthesizer 运行在独立线程中。
MarketDataPublisher 的成员变量
class MarketDataPublisher {
private:
    // 市场更新序列号,从 1 开始
    size_t next_inc_seq_number_ = 1;
    // 撮合引擎与 MDP 之间的队列
    MEMarketUpdateLFQueue *outgoing_md_updates_ = nullptr;

    // MDP 与 snapshot synthesizer 之间的队列
    MDPMarketUpdateLFQueue snapshot_md_updates_;

    volatile bool run_ = false;  // 话说 volatile 关键词的作用究竟是啥,好像没系统学过

    std::string time_str_;
    Logger logger_;

    // 因为是 UDP multicast,所以这里只有唯一的 socket,不区分监听/连接
    Common::McastSocket incremental_socket_;

    SnapshotSynthesizer *snapshot_synthesizer_ = nullptr;
}
MarketDataPublisher::start()
auto MarketDataPublisher::start() {
    run_ = true;

    ASSERT(Common::createAndStartThread(-1, "Exchange/MarketDataPublisher", [this]() { run(); }) != nullptr, "Failed to start MarketData thread.");

    snapshot_synthesizer_->start();
}
MarketDataPublisher::run()
auto MarketDataPublisher::run() noexcept {
    logger_.log("%:% %() %\n", __FILE__, __LINE__, __FUNCTION__, Common::getCurrentTimeStr(&time_str_));

    while (run_) {
        // 在工作循环内不断遍历与撮合引擎通信的无锁队列,
        for (auto market_update = outgoing_md_updates_->getNextToRead(); outgoing_md_updates_->size() && market_update; market_update = outgoing_md_updates_ ->getNextToRead()) {

            logger_.log("%:% %() % Sending seq:% %\n", __FILE__, __LINE__, __FUNCTION__, Common::getCurrentTimeStr(&time_str_), next_inc_seq_num_, market_update->toString().c_str());

            // incremental stream 的消息是不用经过 SnapshotSynthesizer 的
            // Q: 为什么这里要分两次来 send()?
            // A: 分别发送 MDPMarketUpdate 结构体的 seq_num_ 和 MEMarketUpdate 两部分
            incremental_socket_.send(&next_inc_seq_num_, sizeof(next_inc_seq_num_));
            incremental_socket_.send(market_update, sizeof(MEMarketUpdate));
            outgoing_md_updates_->updateReadIndex();

            // 与 SnapshotSynthesizer 通信
            auto next_write = snapshot_md_updates_.getNextToWriteTo();
            // Q:为什么这里不是直接解引用写入?
            // A:因为队列存的是 MDPMarketUpdate 结构体,其2个字段要分别写入
            next_write->seq_num_ = next_inc_seq_num_;
            next_write->me_market_update_ = *market_update;
            snapshot_md_updates_.updateWriteIndex();

            // 市场更新的序列号
            ++next_inc_seq_num_;
        }

        // 是把当前无锁队列当中所有市场更新消息写入应用层缓冲区后,一并写入内核缓冲区
        incremental_socket_.sendAndRecv();
    }

}
SnapshotSynthesizer
SnapshotSynthesizer 成员变量
class SnapshotSynthesizer {
private:
    // MDP 与 SnapshotSynthesizer 之间的通信无锁队列
    MDPMarketUpdateLFQueue *snapshot_md_updates_ = nullptr;

    Logger logger_;

    volatile bool run_ = false;

    std::string time_str_;

    // snapshot stream 的 UDP socket
    McastSocket snapshot_socket_;

    // ??:为什么这里要嵌套 array
    std::array<std::array<MEMarketUpdate*, ME_MAX_ORDER_IDS>, ME_MAX_TICKERS> ticker_orders_;

    size_t last_inc_seq_num_ = 0;  // 标记当前 snapshot 截止到哪一条增量更新序号
    Nanos last_snapshot_time_ = 0;

    MemPool<MEMarketUpdate> order_pool_;
};
std::array<std::array<MEMarketUpdate*, ME_MAX_ORDER_IDS>, ME_MAX_TICKERS> ticker_orders_; 这是一个 array 套 array 得到的二维数组,用 ticker_id_ 和 order_id_ 确认一张订单。意味着 SnapshotSynthesizer 要维护一个撮合引擎当中订单簿的副本快照。后续用于在 snapshot stream 上发布订单簿快照。
Q:既然 SnapshotSynthesizer 有用二维数组存储的订单簿快照,为什么 snapshot stream 仍然要靠 CLEAR 和一条条 ADD 消息来发布快照,为什么不直接把整个二维数组发给客户端?
A:因为二维数组内部存储的是订单指针,指针直接发给客户端无意义。且二维数组内部有大量空槽位,整个数组发送不高效。在 snapshot stream 当中发送 CLEAR 和 ADD 消息可以复用已有数据格式。
// TODO:当然可以设计一套更高效的专门的批量快照协议。要额外花心思,不能复用已有协议。
SnapshotSynthesizer::addToSnapshot()
void SnapshotSynthesizer::addToSnapshot(const MDPMarketUpdate *market_update) {
    // 抽取出 MEMarketUpdate 结构体
    const auto &me_market_update = market_update->me_market_update_;

    // 获取当前合约的所有订单
    auto* orders = &ticker_orders_.at(me_market_update.ticker_id_);

    // 这里用一个 switch statement 来处理各种市场更新
    switch (me_market_update.type_) {
        case MarketUpdateType::ADD: {
            auto order = orders->at(me_market_update.order_id_);

            // 确保该订单号的订单不存在
            ASSERT(order == nullptr, "Received:" + me_market_update.toString() + " but order already exists:" + (order ? order->toString() : ""));
            // 在内存池上分配空间,其实只是把 new 换成 order_pool_.allocate() 而已
            orders->at(me_market_update.order_id_) = order_pool_.allocate(me_market_update);
            break;
        }

        case MarketUpdateType::MODIFY {
            auto order = orders->at(me_market_update.order_id_);

            // 确保该订单号的订单已经存在
            ASSERT(order != nullptr,  "Received:" + me_market_update.toString() + " but order does not exist.");

            // 检查不变量,防止数组下标当中的 order_id_ 与订单实际 order_id 不一致
            ASSERT(order->order_id_ == me_market_update.order_id_, "Expecting existing order to match new one.");
            // 确保 Side 一致
            ASSERT(order->side_ == me_market_update.side_, "Expecting existing order to match new one.");

            // 更新订单的量价
            order->price = me_market_update.price_;
            order->qty = me_market_update.qty_;

            break;
        }

        case MarketUpdateType::CANCEL {
            auto* order = orders.at(me_market_update.order_id_);

            ASSERT(order != nullptr,  "Received:" + me_market_update.toString() + " but order does not exist.");
            ASSERT(order->order_id_ == me_market_update.order_id_, "Expecting existing order to match new one.");
            ASSERT(order->side_ == me_market_update.side_, "Expecting existing order to match new one.");

            order_pool_.deallocate(order);
            orders->at(me_market_update.order_id_) = nullptr;
            break;
        }

        // 对订单簿没有影响的市场更新
        case MarketUpdateType::SNAPSHOT_START:
        case MarketUpdateType::CLEAR:
        case MarketUpdateType::SNAPSHOT_END:
        case MarketUpdateType::TRADE:
        case MarketUpdateType::INVALID:
        break;
    }

    // 确保撮合引擎传来的每条 MDPMarketUpdate 都处理了,更新了 SnapshotSynthesizer 的订单簿快照
    ASSERT(market_update->seq_num == last_inc_seq_num_ + 1, "Expected incremental seq_nums to increase.")
    last_inc_seq_num_ = market_update->seq_num_;
}
SnapshotSynthesizer::publishSnapshot()
snapshot stream 实际是通过一系列消息(而不是单一条包含订单簿所有信息的消息)来帮助客户端重建订单簿的。涉及到的消息类型如下:
- MarketUpdateType::SNAPSHOT_START:表示随后的消息用于重建订单簿
- MarketUpdateType::CLEAR:表示客户端可以清楚其订单簿上的所有订单,等待随后添加
- MarketUpdateType::ADD:订单簿快照中每一个订单对应一条这个类型的消息
- MarketUpdateType::SNAPSHOT_END:表示订单簿快照消息结束。
auto SnapshotSynthesizer::publishSnapshot() {
    size_t snapshot_size = 0;

    // MarketUpdateType::SNAPSHOT_START 消息标识订单簿快照消息开始
    const MDPMarketUpdate start_market_update{snapshot_size++, {MarketUpdateType::SNAPSHOT_START, last_inc_seq_num_}}; //??:为什么用到了 snapshot_size++ 变量?

    logger_.log("%:% %() % %\n", __FILE__, __LINE__, __FUNCTION__, getCurrentTimeStr(&time_str_), start_market_update.toString());

    snapshot_socket_.send(&start_market_update, sizeof(MDPMarketUpdate));

    // 遍历所有合约
    for (size_t ticker_id = 0; ticker_id < ticker_orders_.size(); ++ticker_id) {
        // 这个合约下的所有订单
        const auto& orders = ticker_orders_.at(ticker_id);

        MEMarketUpdate me_market_update;  //??:从空的结构体开始构造吗?为什么不直接构造有数据的结构体?
        me_market_update.type_ = MarketUpdateType::CLEAR;
        me_market_update.ticker_id_ = ticker_id;

        const MDPMarketUpdate clear_market_update{snapshot_size++, me_market_update};
        logger_.log("%:% %() % %\n", __FILE__, __LINE__, __FUNCTION__, getCurrentTimeStr(&time_str_), clear_market_update.toString());

        snapshot_socket_.send(&clear_market_update, sizeof(MDPMarketUpdate));

        // 遍历该合约下所有订单
        for (const auto order: orders) {
            if (order) { // ??:加这层判断意义何在?
                // ??:order 是 MEMarketUpdate* 类型的,那么为何这里还要 *order,那不就是指针的指针了吗?
                const MDPMarketUpdate market_update{snapshot_size++, *order};

                logger_.log("%:% %() % %\n", __FILE__, __LINE__, __FUNCTION__, getCurrentTimeStr(&time_str_), market_update.toString());

                snapshot_socket_.send(&market_update, sizeof(MDPMarketUpdate));
                snapshot_socket_.sendAndRecv();
            }
        }
    } // 遍历所有合约结束

    // MarketUpdateType::SNAPSHOT_START 消息标识订单簿快照消息结束
    const MDPMarketUpdate end_market_update{snapshot_size++, {MarketUpdateType::SNAPSHOT_END, last_inc_seq_num_}};

    logger_.log("%:% %() % %\n", __FILE__, __LINE__, __FUNCTION__, getCurrentTimeStr(&time_str_), end_market_update.toString());

    snapshot_socket_.send(&end_market_update, sizeof(MDPMarketUpdate));
    snapshot_socket_.sendAndRecv();

    logger_.log("%:% %() % Published snapshot of % orders.\n", __FILE__, __LINE__, __FUNCTION__, getCurrentTimeStr(&time_str_), snapshot_size - 1);
}
SnapshotSynthesizer::run()
void SnapshotSynthesizer::run() {
    logger_.log("%:% %() %\n", __FILE__, __LINE__, __FUNCTION__, getCurrentTimeStr(&time_str_));

    while(run_) {
        // 遍历 MDP 与 SnapshotSynthesizer 之间的无锁队列
        for (auto market_update = snapshot_md_updates_->getNextToRead(); snapshot_md_updates_->size() && market_update; market_update = snapshot_md_updates->getNextToRead()) {

            logger_.log("%:% %() % Processing %\n", __FILE__, __LINE__, __FUNCTION__, getCurrentTimeStr(&time_str_), market_update->toString().c_str())

            // 让市场更新作用于 SnapshotSynthesizer 维护的订单簿快照
            addToSnapshot(market_update);

            snapshot_md_updates_->updateReadIndex();
        } // 循环结束,订单簿快照得到了一轮更新

        // 若距离上次发送快照的时间间隔已经足够长,则发送快照
        if (getCurrentNanos() - last_snapshot_time_ > 60 * NANOS_TO_SECS) {
            last_snapshot_time = getCurrentNanos();
            publishSnapshot();
        }
    }
}
交易所主程序
我们上一章学习的交易所主程序时还未学习 OrderServer 和 MarketDataPublisher。此处在交易所主程序 exchange_main 当中加入这两个组件。
Exchange::MatchingEngine *matching_engine = nullptr;
Exchange::MarketDataPublisher *market_data_publisher = nullptr;
Exchange::OrderServer *order_server = nullptr;

int main(int, char **) {
    logger = new Common::Logger("exchange_main.log");

    std::signal(SIGINT, signal_handler);

    const int sleep_time = 100 * 1000;

    // 创建三条无锁队列
    Exchange::ClientRequestLFQueue client_requests(ME_MAX_CLIENT_UPDATES);
    Exchange::ClientResponseLFQueue client_responses(ME_MAX_CLIENT_UPDATES);
    Exchange::MEMarketUpdateLFQueue market_updates(ME_MAX_MARKET_UPDATES);

    std::string time_str;

    // 创建并启动撮合引擎
    matching_engine = new Exchange::MatchingEngine(&client_requests, &client_responses, &market_updates);
    matching_engine->start();

    // 配置 MDP 的接口、IP和端口,然后创建并启动 MDP
    const std::string mkt_pub_iface = "lo"; // 网络接口。其实就是走哪个网卡是吧?

    const std::string inc_pub_ip = "123.456.78.2";
    const int inc_inc_port = 20001;

    const std::string snap_pub_ip = "123.456.78.1";
    const int snap_pub_port = 20000;

    market_data_publisher = new Exchange::MarketDataPublisher(&market_updates, mkt_pub_iface, snap_pub_ip, snap_pub_port, inc_pub_ip, inc_pub_port);
    market_data_publisher->start();

    // 配置 OrderServer 的接口、端口
    const std::string order_gw_iface = "lo";  // 这里又叫 gw,有病吧,gw 应该是客户端的吧。TODO:重命名
    const int order_gw_port = 12345;

    order_server = new Exchange::OrderServer(&client_requests, &client_responses, order_gw_iface, order_gw_port);
    order_server->start();

    while (true) {
        usleep(sleep_time * 1000);  // 啥也不用做了,睡觉就好。
    }
}